这篇教程解决什么:把一段真人出镜的口播长视频,从「转写文字 → 找出口误和废话 → 剪掉 → 配字幕/BGM/动效 → 导出成片」整条链路交给 AI 跑完。你只需要把素材放进一个文件夹、说清楚要求,剩下的在 ChatCut 编辑器里验收。
适合谁:做知识口播、工具测评、方法论讲解的创作者;想把剪辑时间从 3 小时压到 10 分钟的人。
预计上手时间:首次配置约 10 分钟(装连接器 + 装 Skill + 切模型),之后每期只需给素材 + 下指令。
先看这篇教程要用到的两个主角:WorkBuddy 是你的指令入口(负责理解你要什么、调度流程),ChatCut 是云端 AI 剪辑器(真正执行剪切、字幕、混音、特效、导出)。两者通过「连接器」打通。
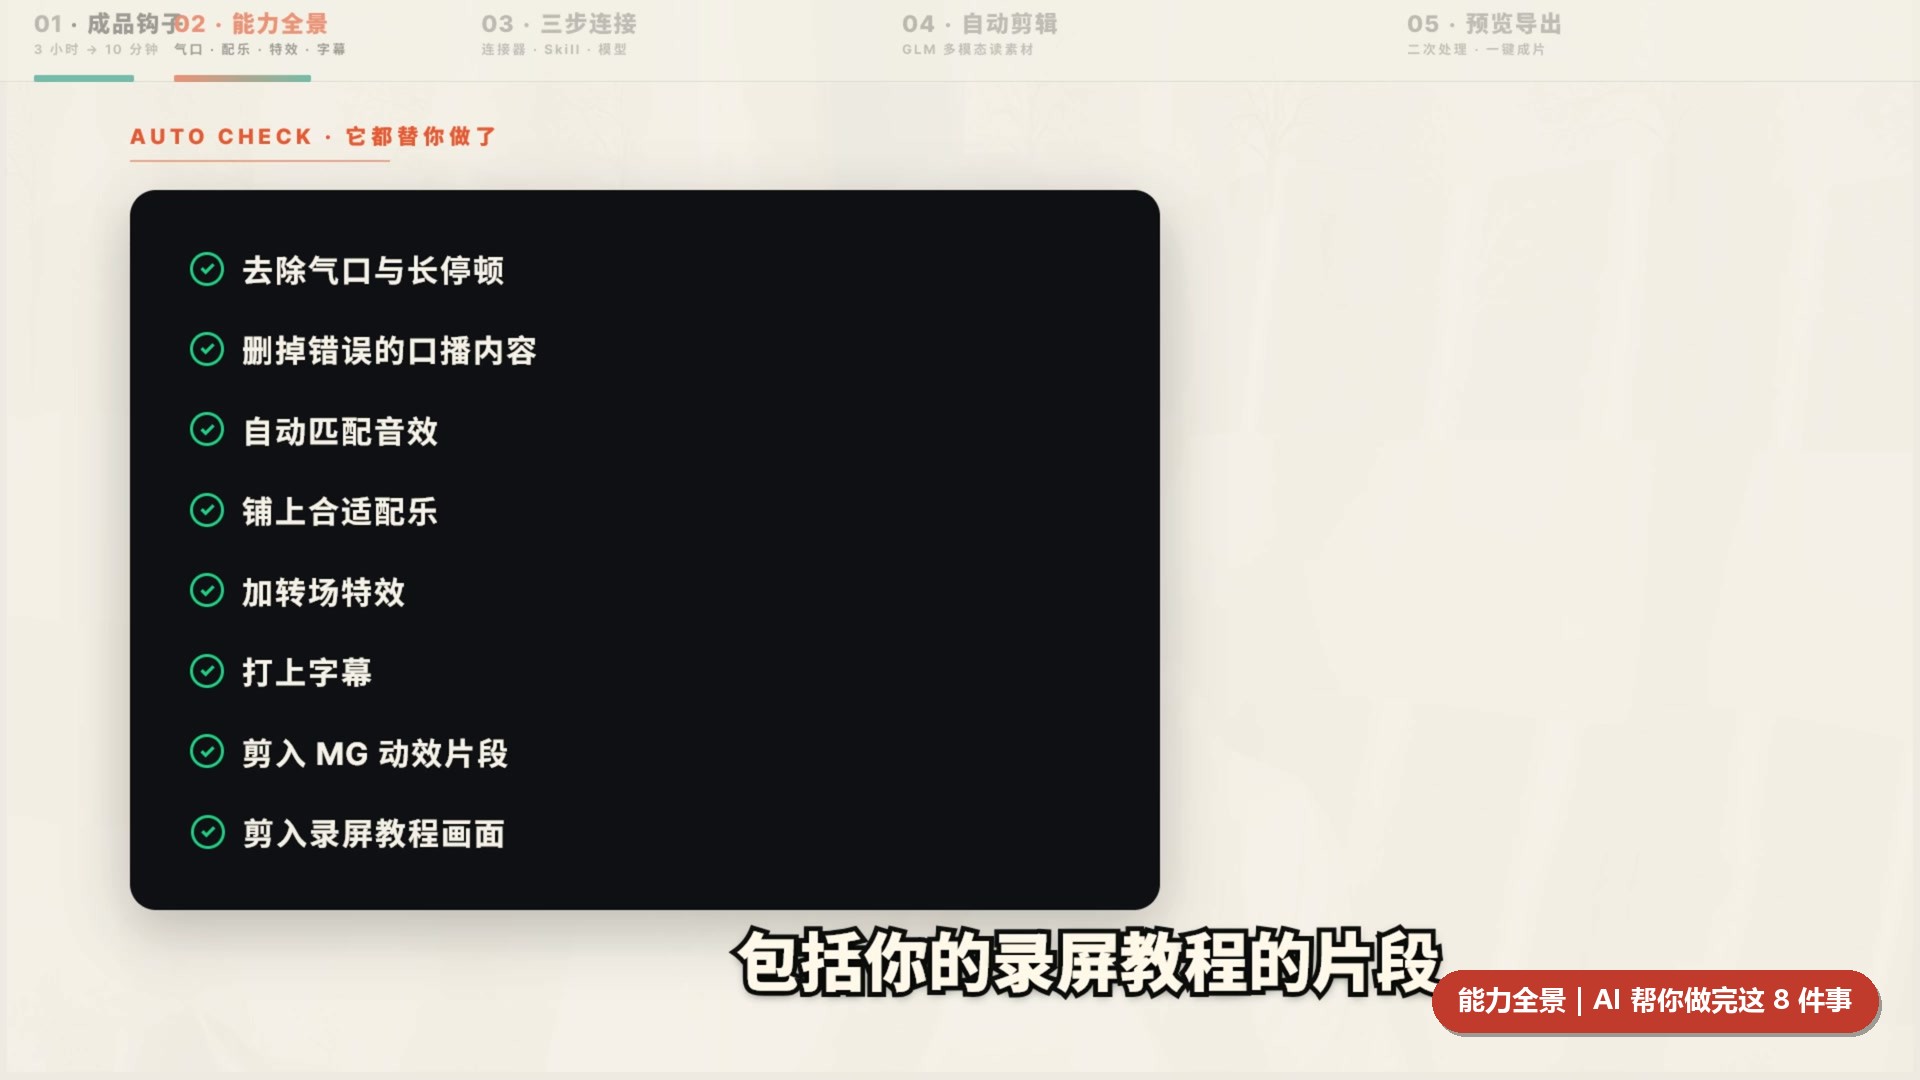
能力清单先摆在这里——这些活儿 AI 都会替你做完,不需要你逐条操作:
准备工作:先把这个文件夹建好
整个流程能跑顺的前提,是素材都在一个文件夹里。原因是我们要用的 GLM-5.3-Flash 是原生多模态模型,能直接读取文件夹里的视频画面,所以素材越集中,它理解得越完整。
建议按下面这张清单准备,folder 里不要混入不相关的文件(模型会全部读一遍,无关文件会干扰判断):
文件类型 | 准备什么 | 注意事项 |
|---|---|---|
主口播视频 | 一次录完整的真人出镜原片,不用自己剪 | 普通话、单人、声音清晰;原片保留完整,气口和口误不用手动删 |
录屏素材 | 要插入成片的操作录屏 | 时长控制在需要展示的片段即可 |
配图 / 截图 | 要露出界面的截图、图表 | 命名写成「提示词-01」「完整版-02」这类,AI 更容易对应到口播内容 |
BGM | 背景音乐(可选) | 没有也可以,让 AI 自己配 |
参考资料 | 口播文案、脚本、参考风格截图 | 有的话给上,AI 会拿它和转写稿逐句对照 |
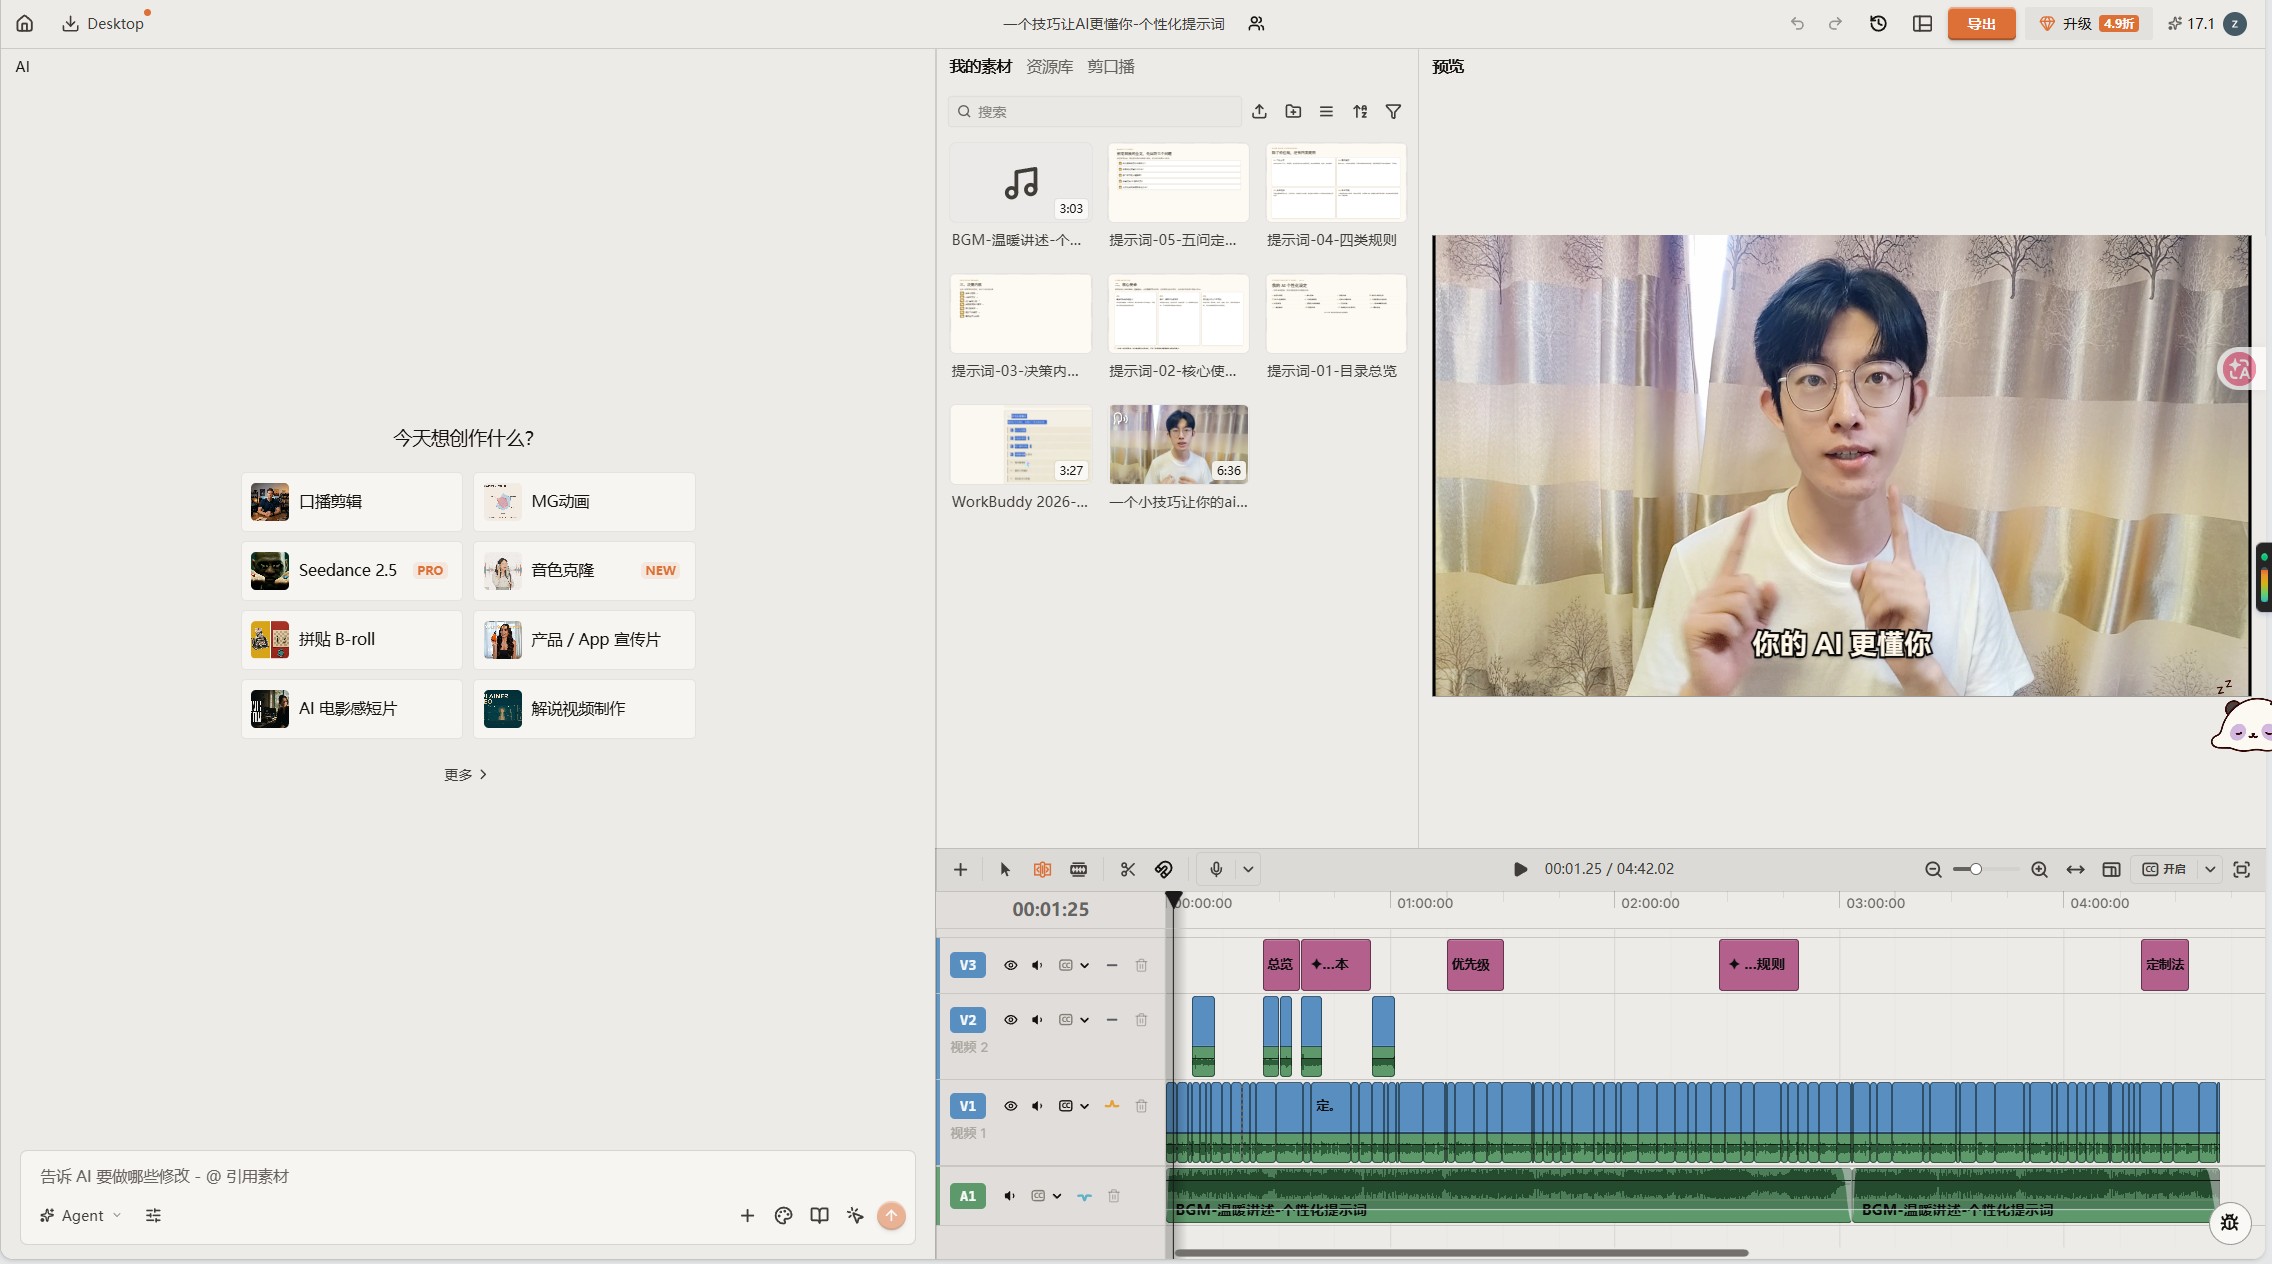
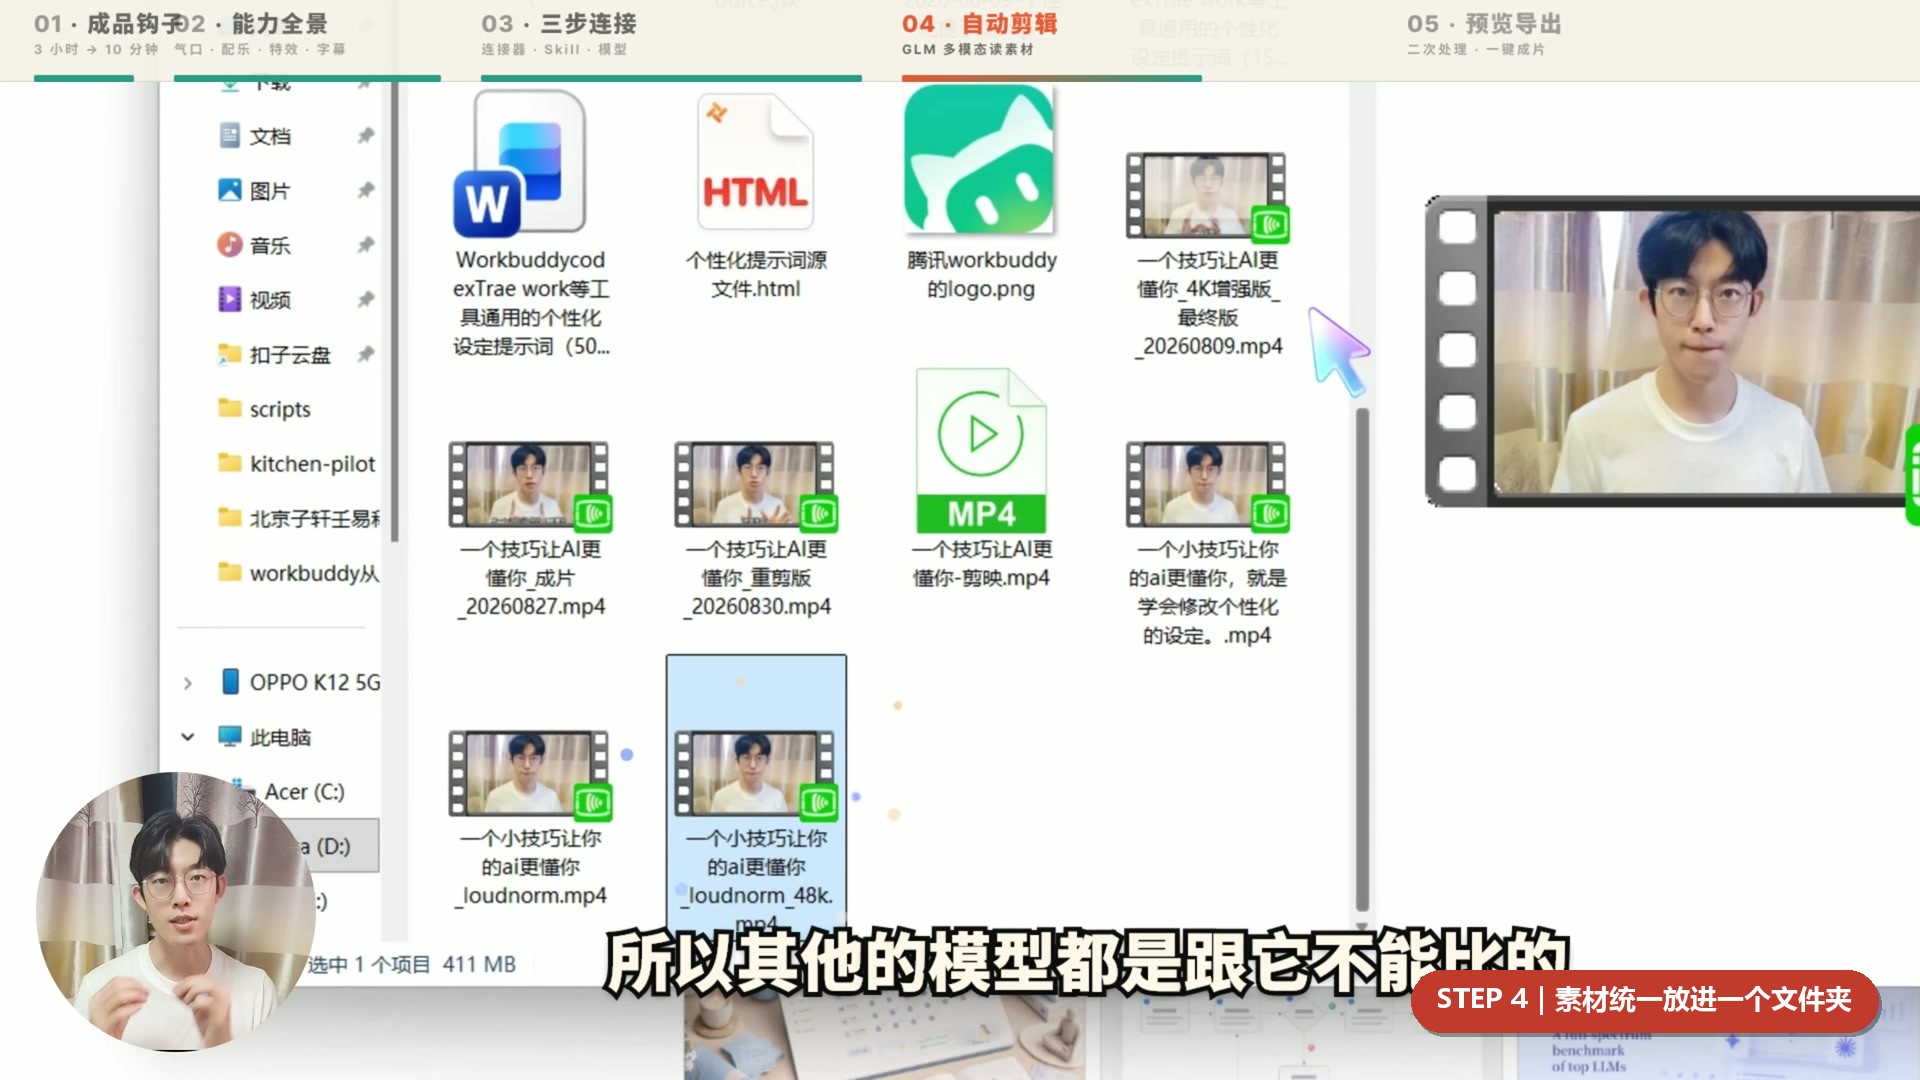
一个真实例子:本次演示使用的文件夹里放了 1 个主口播视频、3 个录屏/增强版片段、1 个 BGM、1 张 logo、2 份提示词文档和 1 份个性化提示词素材截图,共 34 个条目 411MB。AI 全部读完后才开始干活。
STEP 1 装好 ChatCut 连接器
连接器是 WorkBuddy 调用外部服务的通道。这一步不需要你去官网下载、配置 API Key——直接复制官方指令发给 WorkBuddy,它会自己完成安装、授权和验证。
把下面这句话整段复制到对话框发送:
官方指令 · 可直接复制
帮我根据安装说明安装 chatcut 连接器:https://chatcut.io/workbuddy
发送后你会看到 WorkBuddy 自动完成一系列动作:读取安装说明 → 下载连接器 → 拉起授权页面 → 验证连通性。中途如果弹出授权页,需要你本人点击确认(权限这一步 AI 不能替你点)。
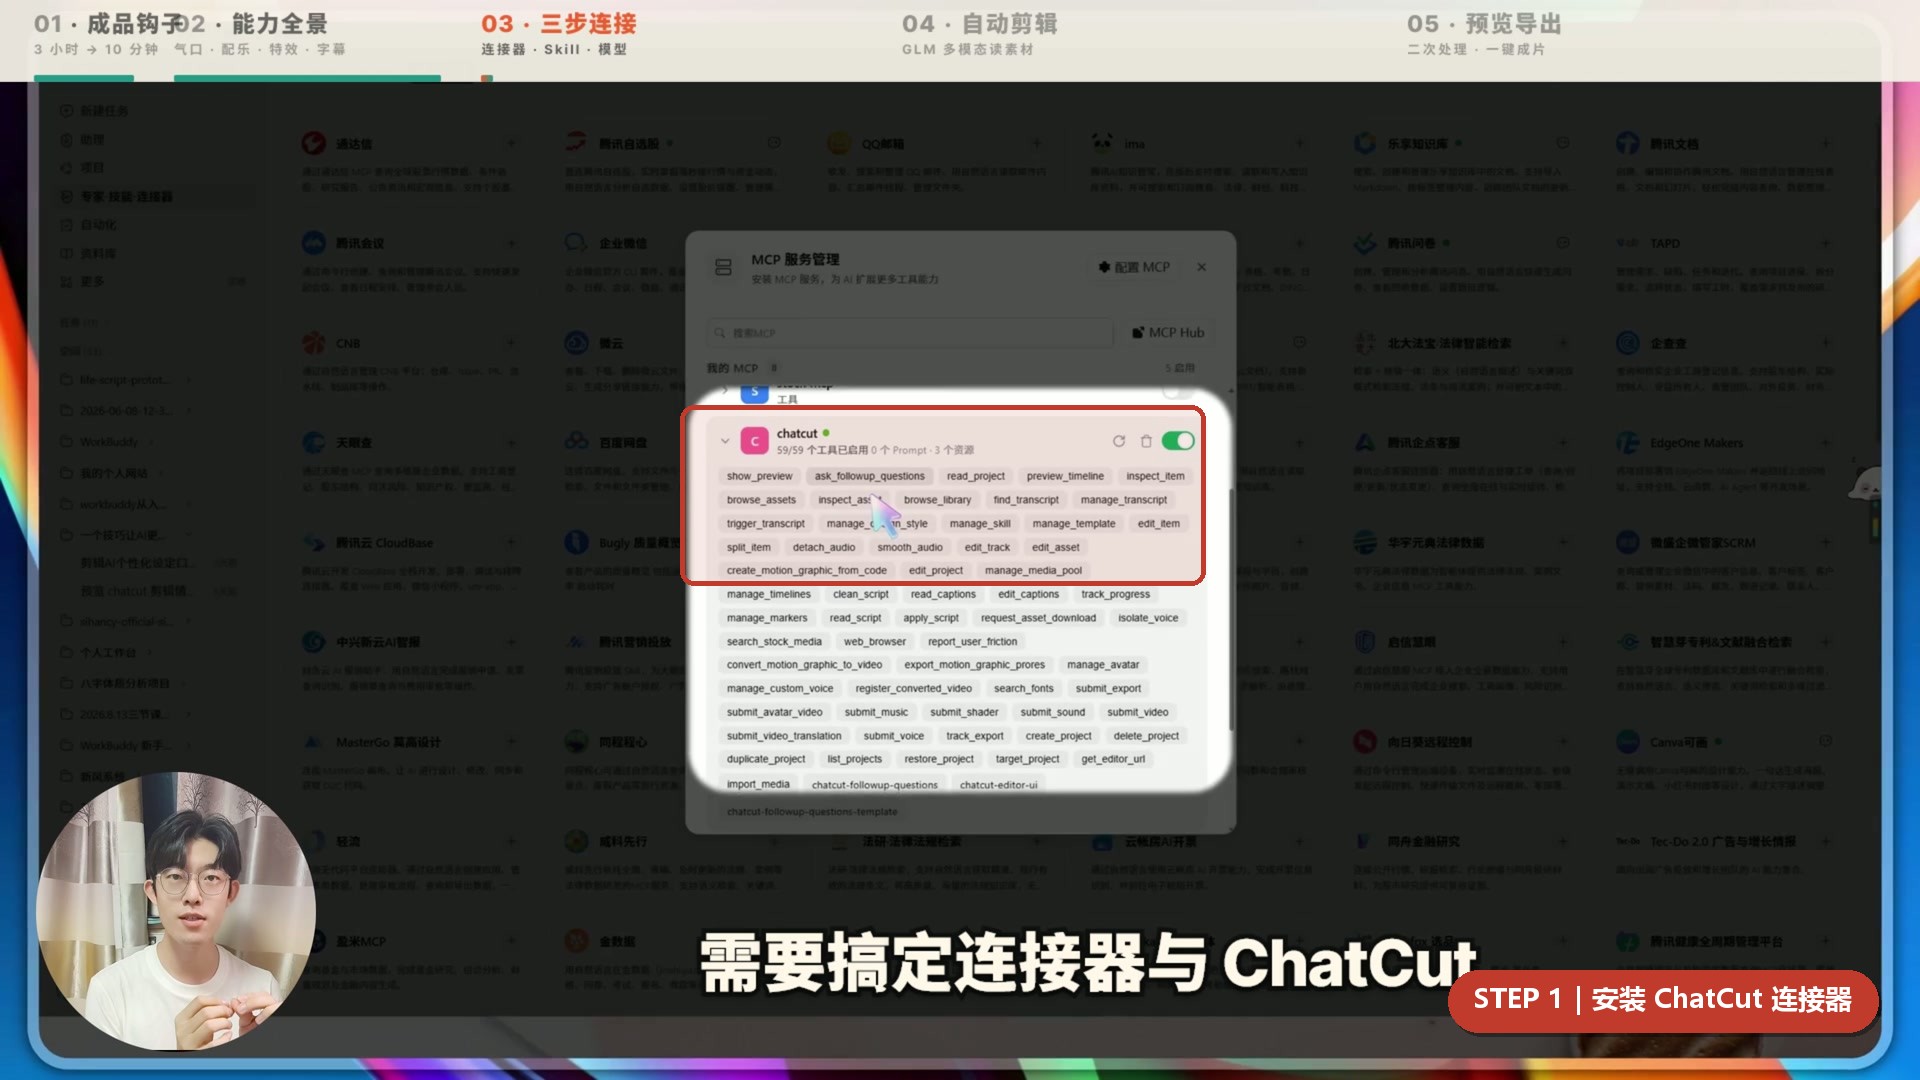
安装成功的判断标准很直观:连接器管理页里 ChatCut 显示为「已连接」,并且能看到它挂载的工具列表(导入素材、读取时间轴、编辑字幕、控制音量、提交导出等):
两个容易踩的坑:
1. 授权有时效:连接器的访问凭据(Bearer Token)有效期大约 1 小时。如果隔了很久再用,可能提示授权过期——告诉 WorkBuddy「重新认证一下」,它会重新拉起授权,不用重装。
2. 界面刷新问题:如果装完了但界面上没显示出来,先刷新页面再看;刷新后仍然没有,就告诉 WorkBuddy 帮你检查连接状态。
STEP 2 装上「知识口播」剪辑 Skill
连接器解决的是「能不能调用」,Skill 解决的是「剪得好不好」。Skill 是把一套剪辑规范沉淀下来的能力包——字幕怎么排、BGM 什么时候压、动效卡什么时候出现、人声标准是多少,都写在里面了。
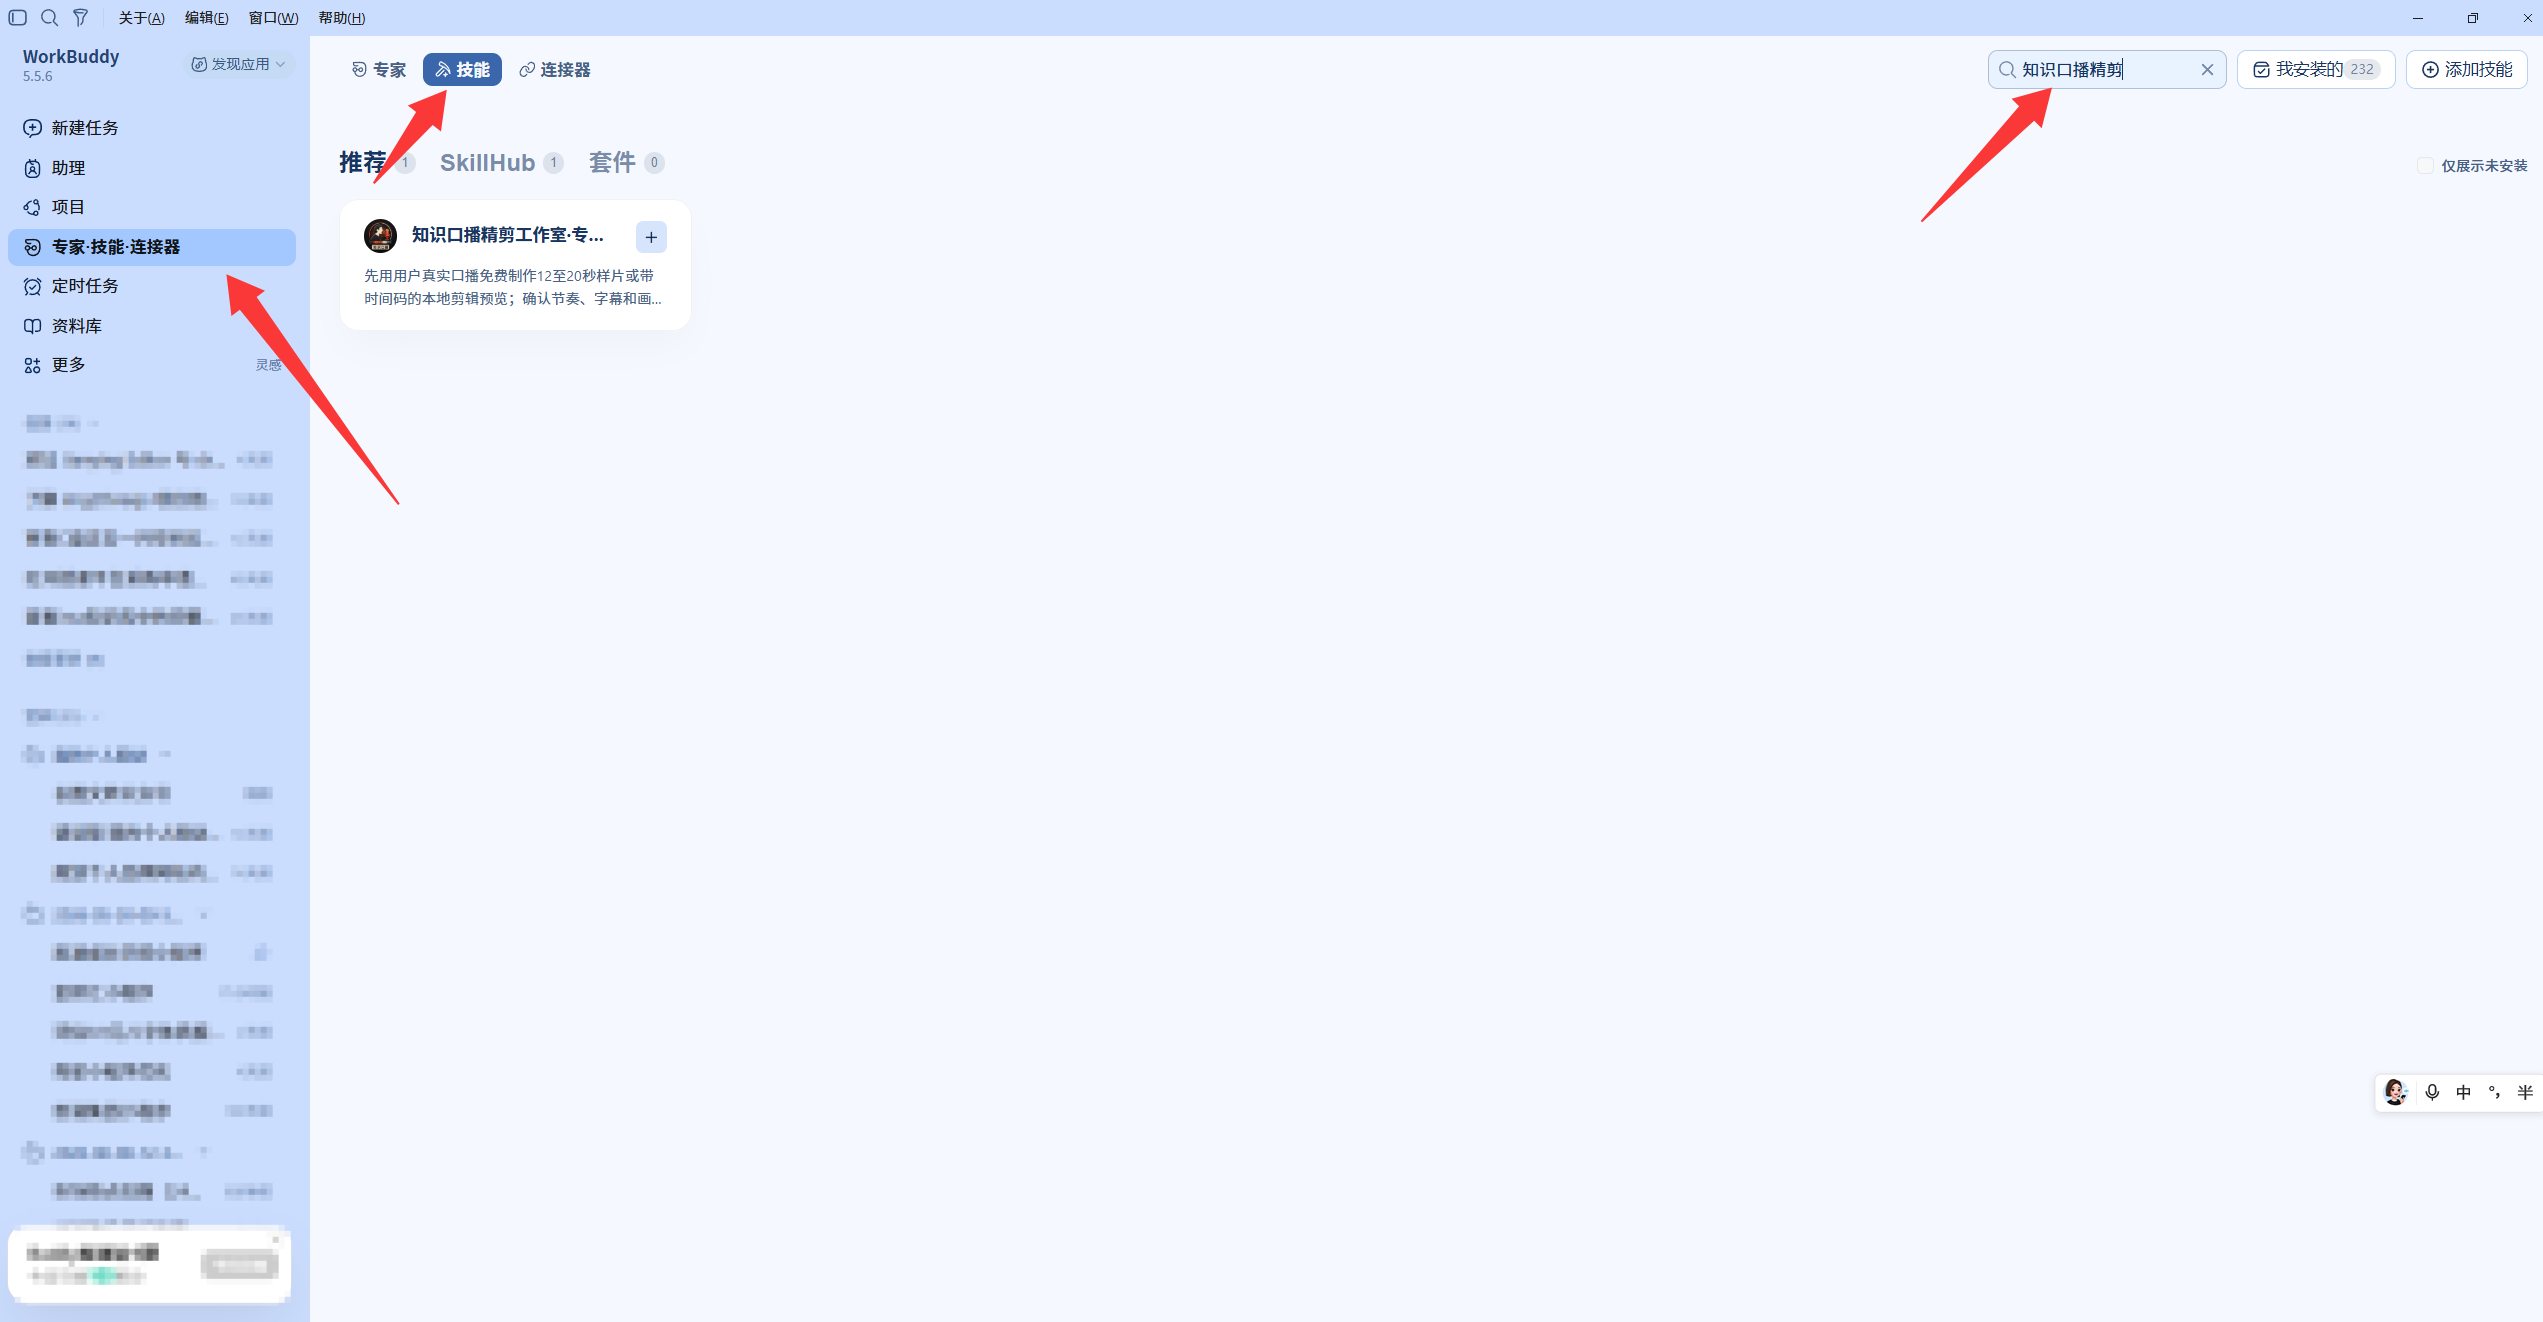
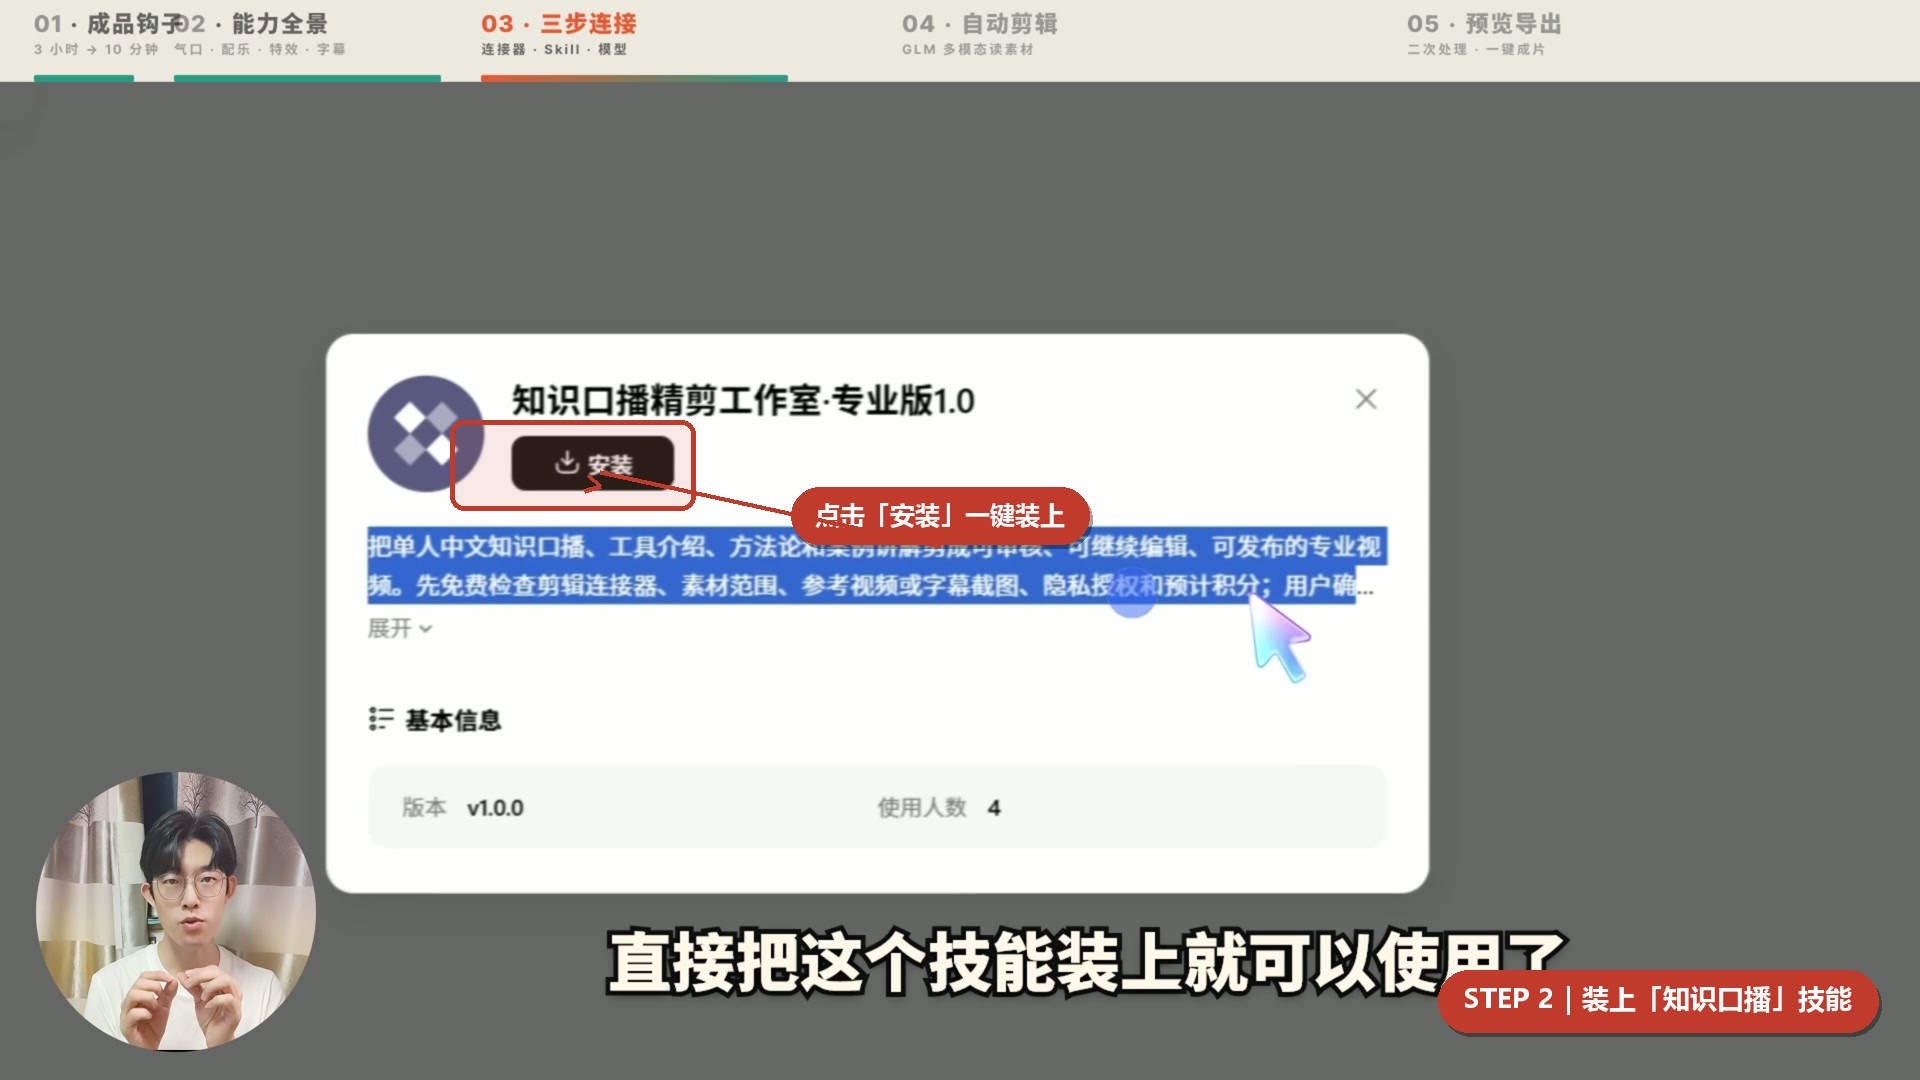
操作路径:打开左侧「技能中心」→ 搜索框输入知识口播 → 在结果里点开 SkillHub 页面 → 点击「安装」。
装好后建议花半分钟看一下它的说明,知道自己用的是什么:
- 它的定位:把单人中文知识口播、工具介绍、方法论和案例讲解,剪成可审核、可继续编辑、可发布的专业视频。
- 它的工作方式:先免费检查剪辑连接器、素材范围、是否涉及推广内容、隐私授权和预计消耗积分;你确认之后才进入正式制作,生成字幕、真实数据画面、适量动效卡、BGM 与混音,并交付一版可编辑时间轴。
- 它的边界:不适用于 Vlog、多机位访谈、长课程,以及未授权的视频自动发片。
STEP 3 切到 GLM-5.3-Flash 模型
这一步最容易被忽略,但直接决定成败——其他模型读不了视频。我们要让 AI 真正「看」画面(判断哪里该插录屏、哪段口播在讲界面操作),必须用原生多模态模型。
操作路径:新建对话 → 点右下角的模型选择器 → 选中 GLM-5.3-Flash。
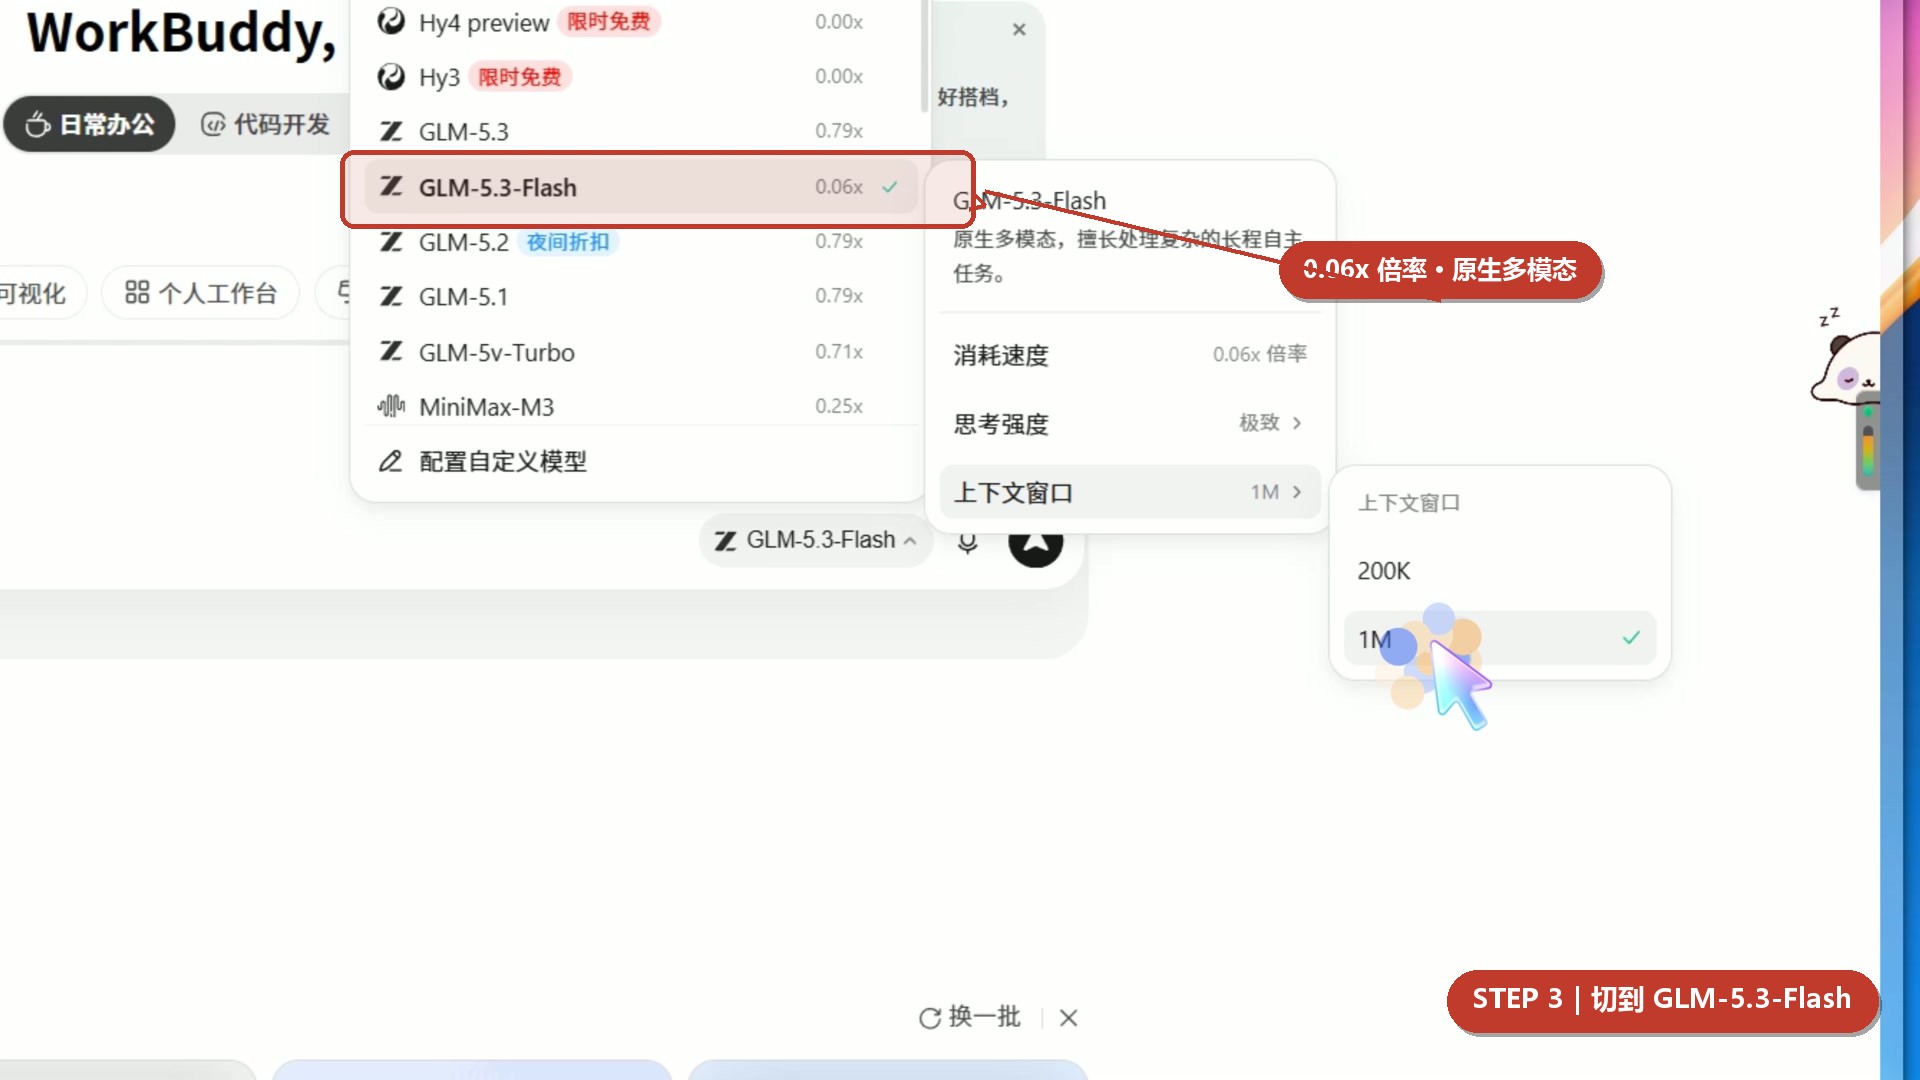
它为什么合适,看菜单里的三个参数就明白:
参数 | 数值 | 对剪辑意味着什么 |
|---|---|---|
消耗倍率 | 0.06x | 相比同系列 1x 档位的模型,长时间、多轮对话的成本低一个量级 |
能力定位 | 原生多模态,擅长长程自主任务 | 能读视频和图片;能自己跑完「转写→判断→剪辑→检查」多步流程而不跑偏 |
上下文窗口 | 可选 200K / 1M | 口播长、素材多的时候选 1M,避免前面的转写内容被遗忘 |
STEP 4 发起任务:挂载技能 + 交素材 + 说要求
三件事在同一个对话框里完成:
- 点击左下角的「+」,在技能列表里选中知识口播精剪工作室(挂载后输入框上方会出现技能标签)
- 引用你的素材文件夹(把文件夹路径给 WorkBuddy,或使用引用功能选中该文件夹)
- 输入你的剪辑要求,发送
素材一致放在一个文件夹里,AI 才能全部识别:
指令不用写得很复杂,但要说清三件事:素材在哪、按什么规范剪、交付到哪一步停。下面这段可以直接改用:
剪辑指令模板 · 可直接复制
这个文件夹里是我这期视频的全部素材:主口播视频、录屏片段、配图。请按「知识口播精剪」的规范帮我剪一版:
1. 先把口播转写成文稿,逐句和我的原意核对,把发现的问题列出来(重复、半截话、口误、错别字)再动手剪;
2. 剪完交付可继续编辑的时间轴,带字幕、BGM 和必要的动效卡,需要插录屏/配图的位置帮我匹配好;
3. 先不要导出,给我预览链接,等我看过确认。
为什么把「先列问题再剪」写进去:剪辑是不可逆操作。让 AI 先把判断摊开给你看,你能立刻发现它有没有理解错,比剪完再返工省事得多。
STEP 5 AI 到底做了什么(这一步值得细看)
发送之后你不用盯着,AI 会按顺序跑完这几个阶段。了解过程,你才知道验收时该看哪里。
阶段一:上传与转写
AI 会为这个项目建立一个临时上传会话,把文件夹里的媒体传进云端项目,然后自动开始转写。本次演示的素材转写结果为 154 段,逐段带时间码。
阶段二:逐句核对,先找问题不动刀
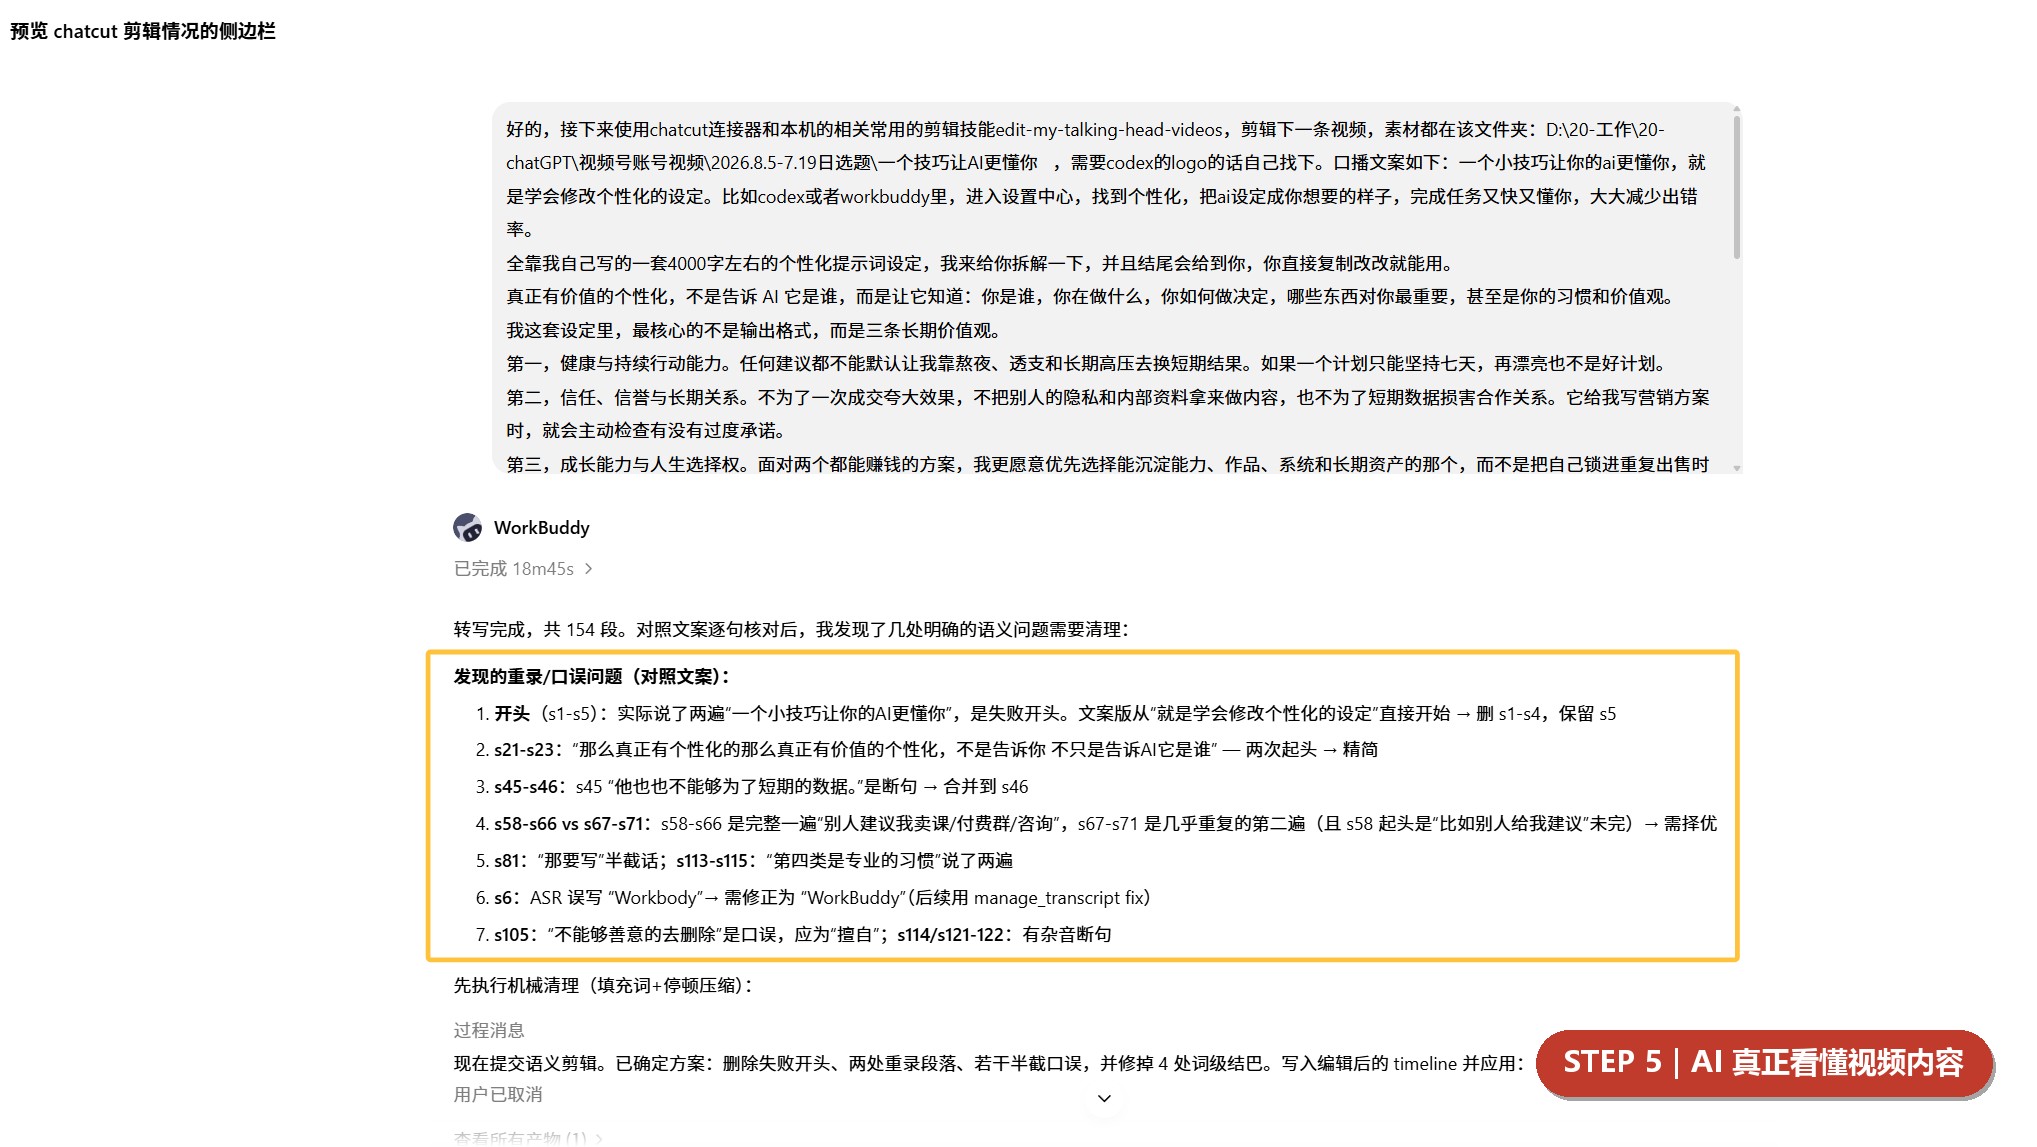
转写完成后,AI 会把转写稿和你的原意逐句对照,列出「明确需要清理的问题」。本次实测找出了 7 处,类型很有代表性:
问题类型 | 实际例子 | 处理方式 |
|---|---|---|
开场反复重录 | 同一句「AI 终于可以帮我们……」录了多遍 | 只保留最完整、最顺的一遍,其余删除 |
半截口误 | 「AI 终于可以帮我们指」「帮我安装说明等等等」 | 整句删除,或修剪到语意完整 |
同义重复 | 「去除口播中的口气」后紧接「去除口播中的气口」 | 保留正确的一句,去掉重复 |
转写错别字 | 把「WorkBuddy」识别成「Workbody」 | 字幕层批量修正专有名词 |
语义硬伤 | 口误导致前后矛盾、句子不成立 | 标记出来,删掉或调整断句 |
阶段三:机械层 → 语义层,分两步剪
确认方案后,AI 分两层执行:
- 机械层(不需要判断的部分):填空题状停顿、压缩过长静音、去掉无意义语气词。
- 语义层(需要理解的部分):删除失败开场、删掉重录段落、修掉半截口误和语义硬伤。
本次实测:82 段转写行被剪成 1 条完整视频,成片时长 3 分 52 秒(6949 帧 / 30fps),并同步生成了 95 条字幕。
阶段四:贴字幕、配 BGM、加动效
同一轮里,AI 还会把画面层补齐:字幕按规范排版、BGM 铺上并做自动压低处理、需要的动效卡(开场信息卡、能力清单卡、流程卡等)按口播节奏放进去。本次项目实际生成的时间轴结构是:
轨道 | 内容 |
|---|---|
主视频层 | 口播 A-roll 剪辑结果(82 段转写合成) |
素材层 | 录屏片段插入 + 配图/截图 |
字幕层 | 95 条自动字幕(含专有名词修正) |
动效层 | 开场磨砂信息卡、能力清单卡、五步流程卡、模型对比卡、章节进度条、焦点转移圆环等 |
音频层 | 人声母带 + BGM(自动跟随压低) |
STEP 6 打开 ChatCut 编辑器预览和微调
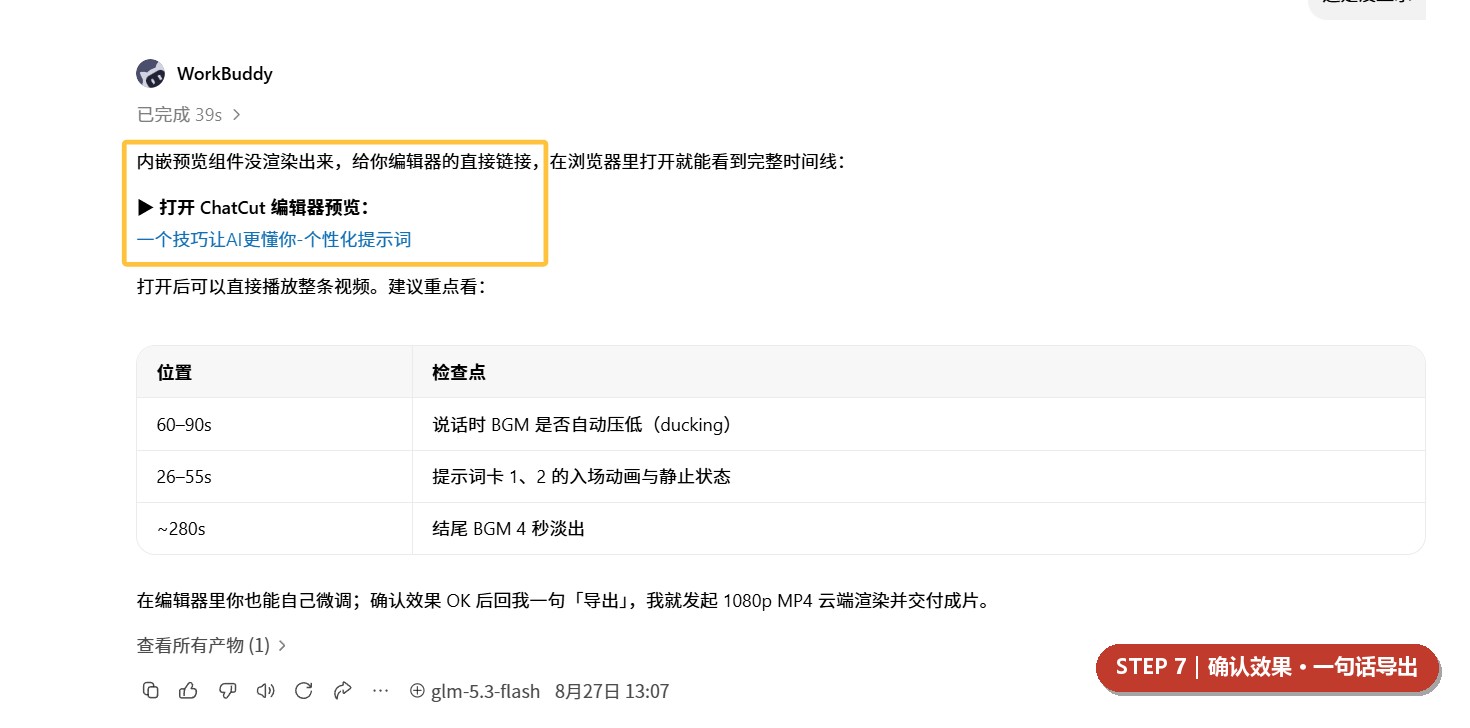
AI 跑完会给你一个编辑器链接。点开就能在浏览器里看到完整时间轴——这不是一张不可改的成片,而是可以继续动的工程。
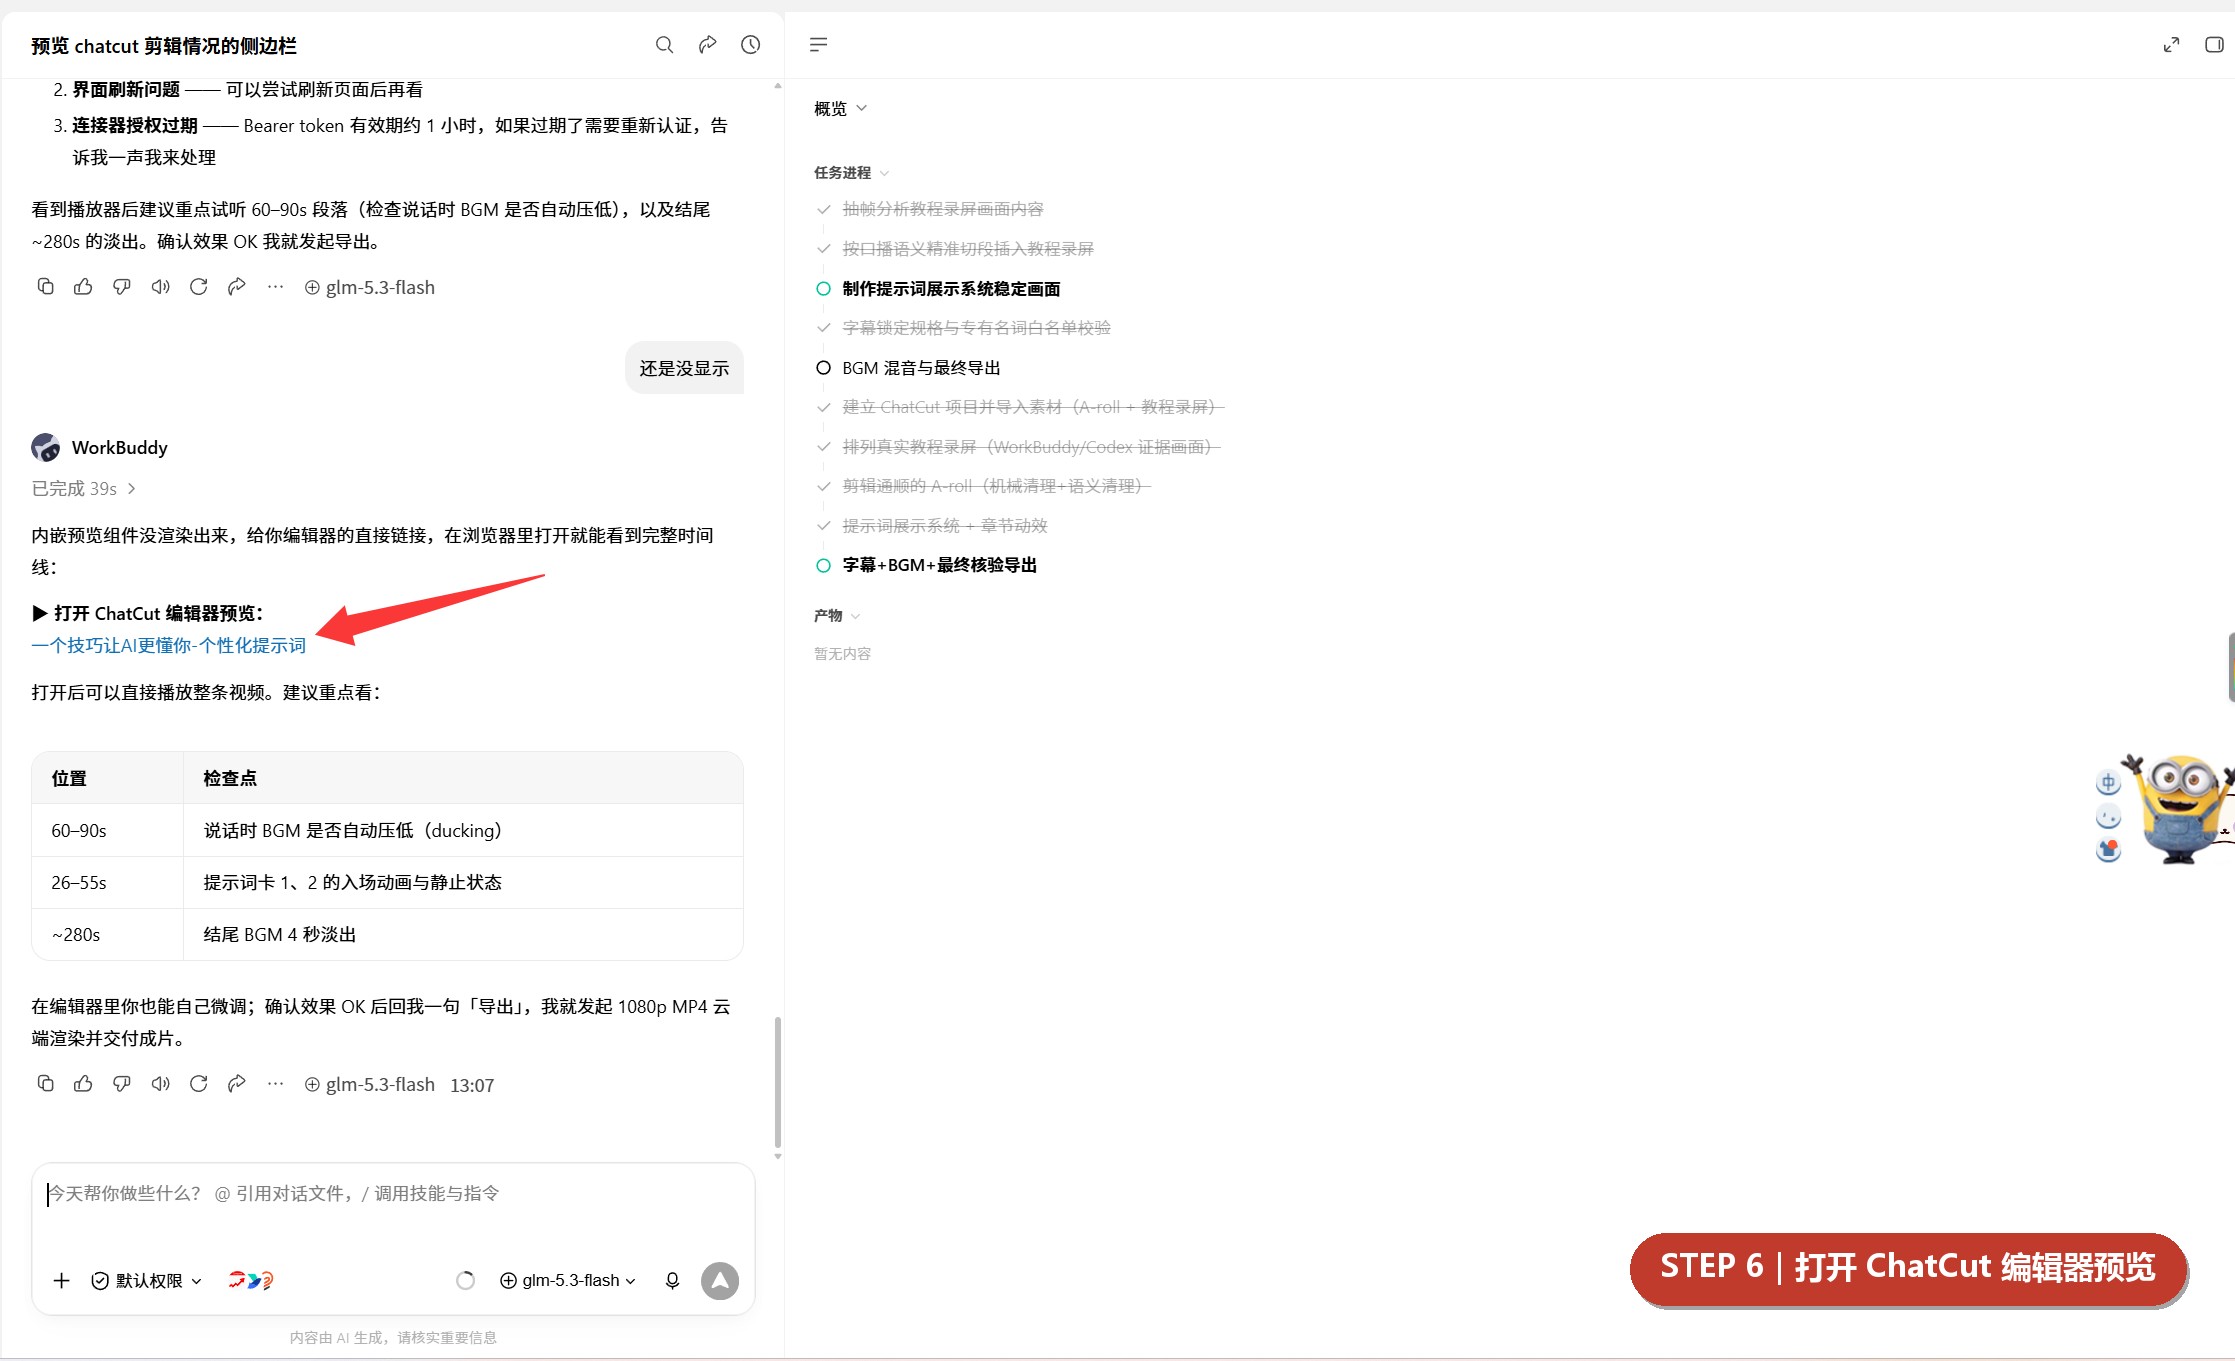
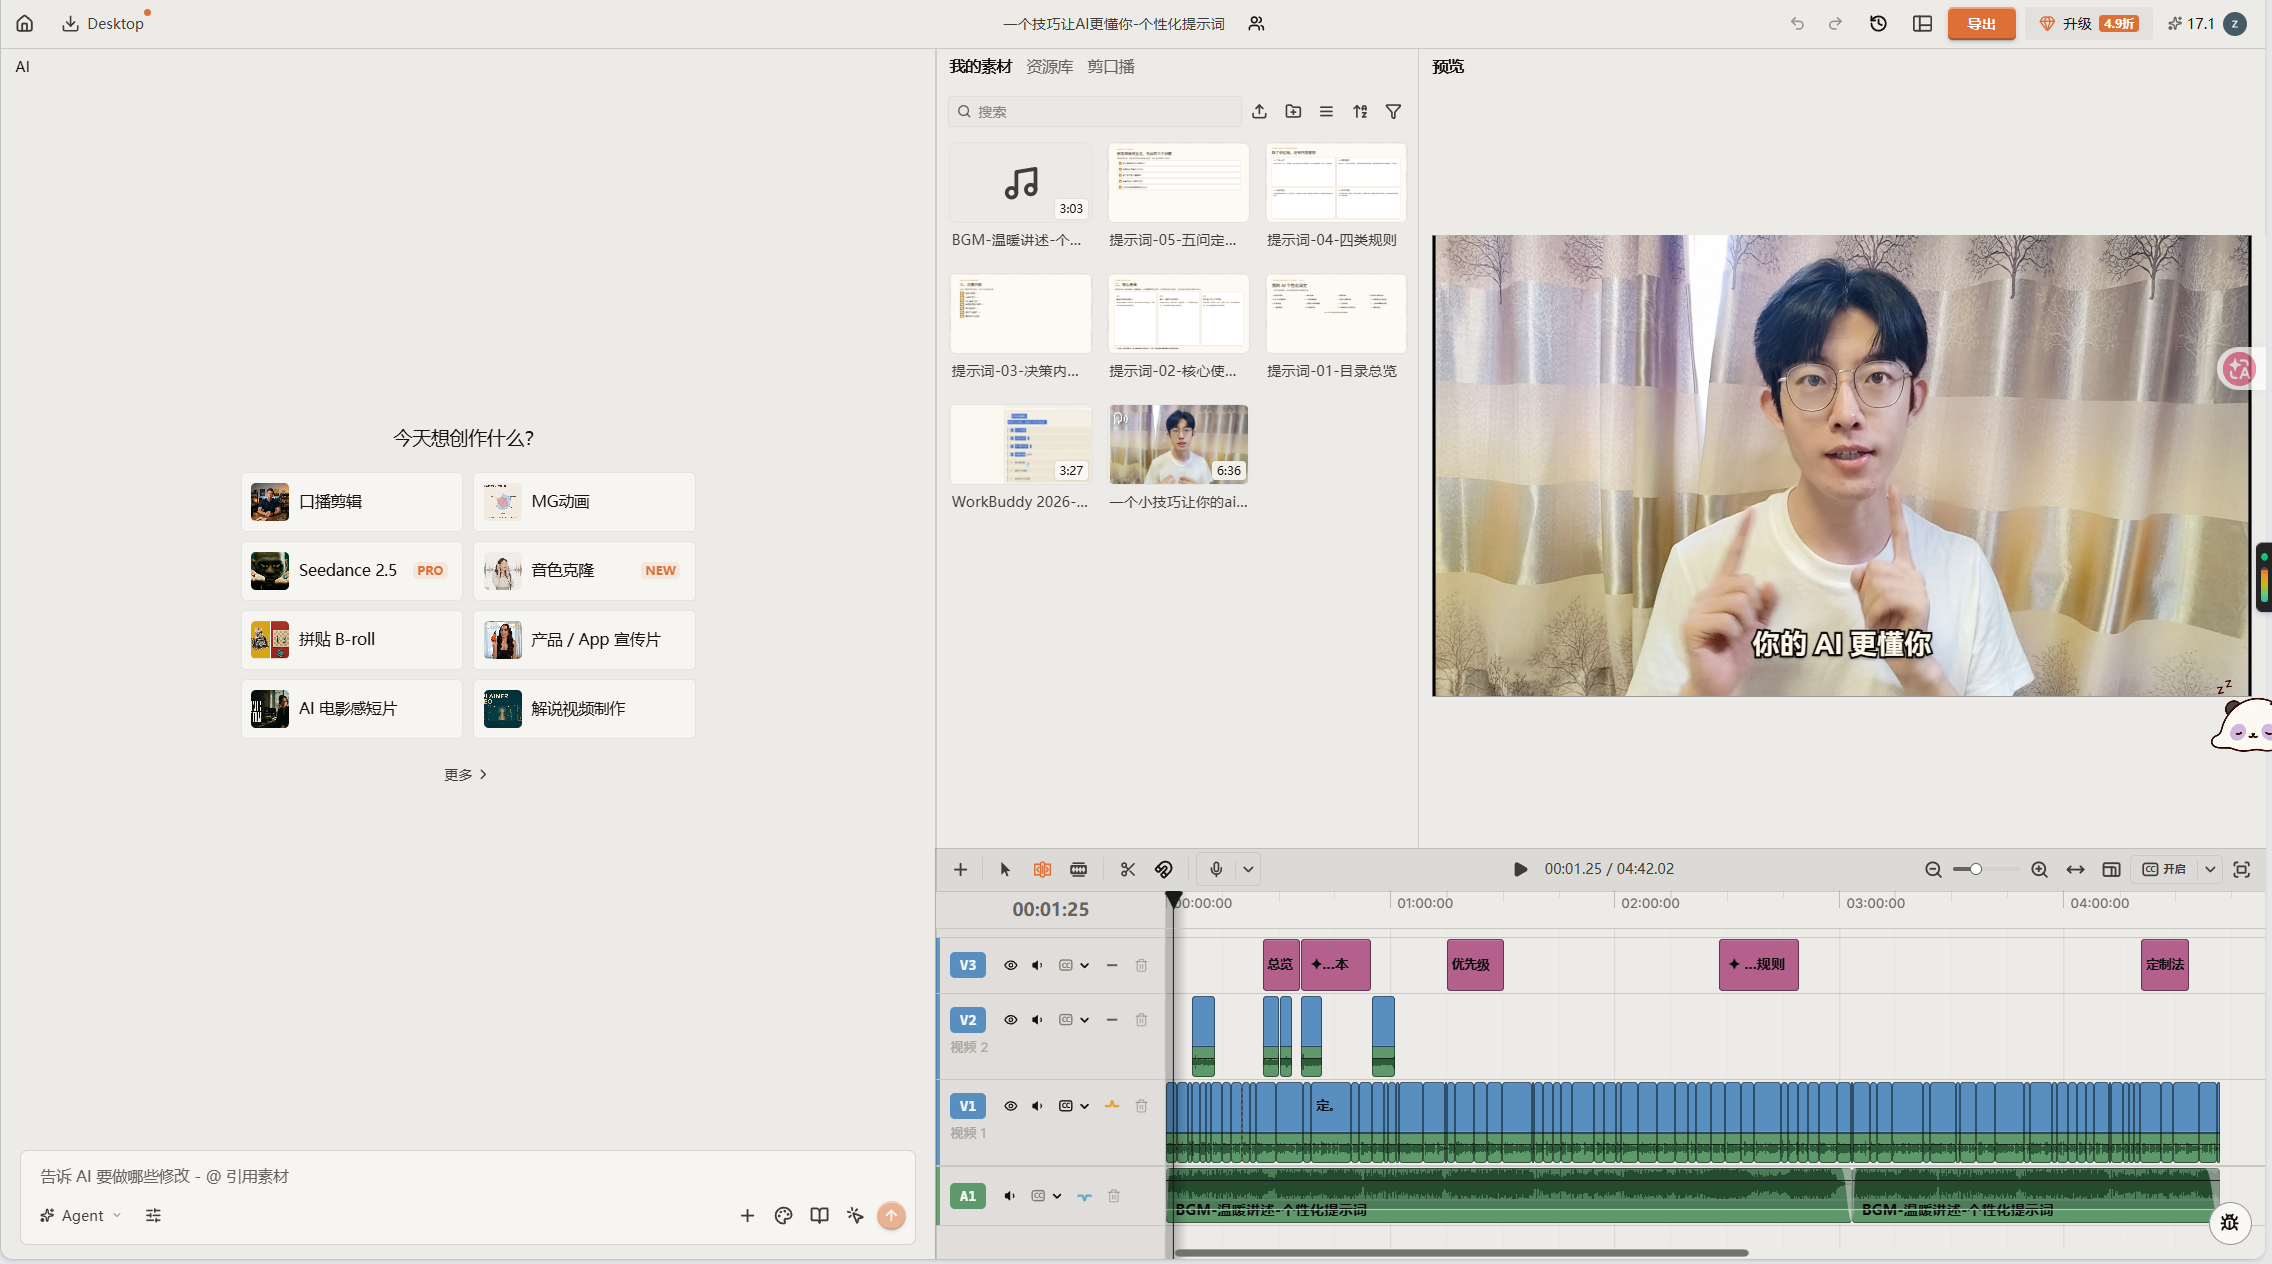
发现要改的地方,两种方式:可以在对话里描述(「第 2 分钟那段字幕把 XX 改成 YY」),也可以直接在编辑器里手动改(拖时间轴、改字幕文本、调音量)。
STEP 7 导出成片
确认没问题后,在对话里回一句「导出」就行,不需要自己找导出按钮。AI 会提交云端渲染任务,输出 1080p MP4。
不过如果要想导出超清4K的,建议下载chatcut桌面端,手动导出是可以导出4K的,云端的要付费才行。
导出期间注意两件事:
- 进度在哪看:编辑器右上角的导出队列面板;关掉了就点导出按钮右侧的队列图标重新打开。
- 文件去哪了:渲染完成后会自动下载到你本机,不需要手动另存。
改结构要谨慎:如果你在导出前对成片结构做了大幅调整(比如删掉整段、重排顺序),人声层的母带需要重新生成,否则可能出现音量忽大忽小。这种情况直接告诉 AI「我改了结构,请重新处理人声」。
常见问题排查
现象 | 原因 | 怎么处理 |
|---|---|---|
提示授权过期 / 连接失败 | 连接器凭据有效期约 1 小时 | 让 WorkBuddy 重新认证,不用重装 |
装好了但界面没显示 | 界面刷新问题 | 先刷新页面;仍不行就让 AI 检查连接状态 |
AI 说读不到视频内容 | 模型选错了 | 切回 GLM-5.3-Flash(必须是原生多模态) |
素材没被识别 | 文件不在同一文件夹,或格式不支持 | 统一放进一个文件夹后重新引用 |
预览在对话里没渲染出来 | 内嵌预览组件偶发不加载 | 用 AI 给的链接在浏览器里打开,功能完全一致 |
字幕有错别字 | 语音识别对专有名词不敏感 | 把正确写法告诉 AI,让它批量替换 |
想只改一小段 | —— | 用时间点描述位置(「1 分 20 秒那句」),定位最准 |
能力边界:什么能剪,什么不能剪
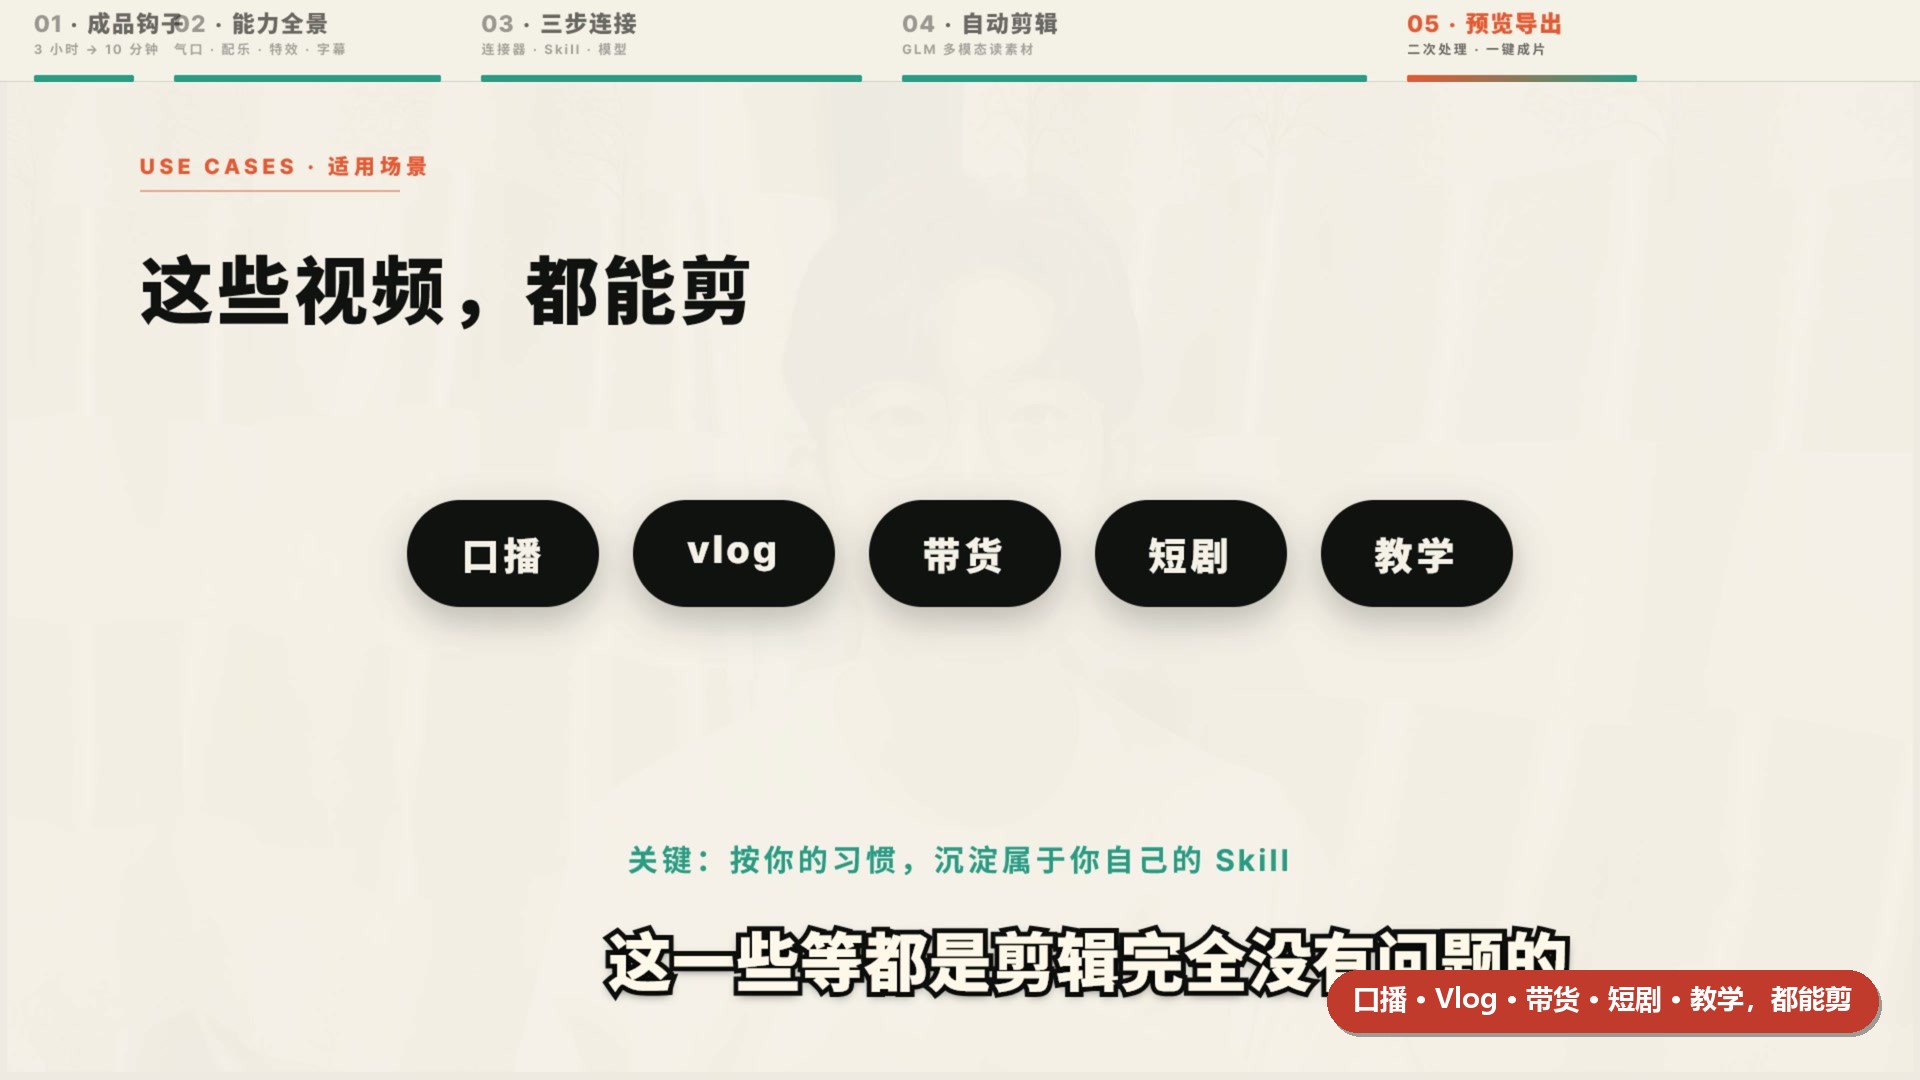
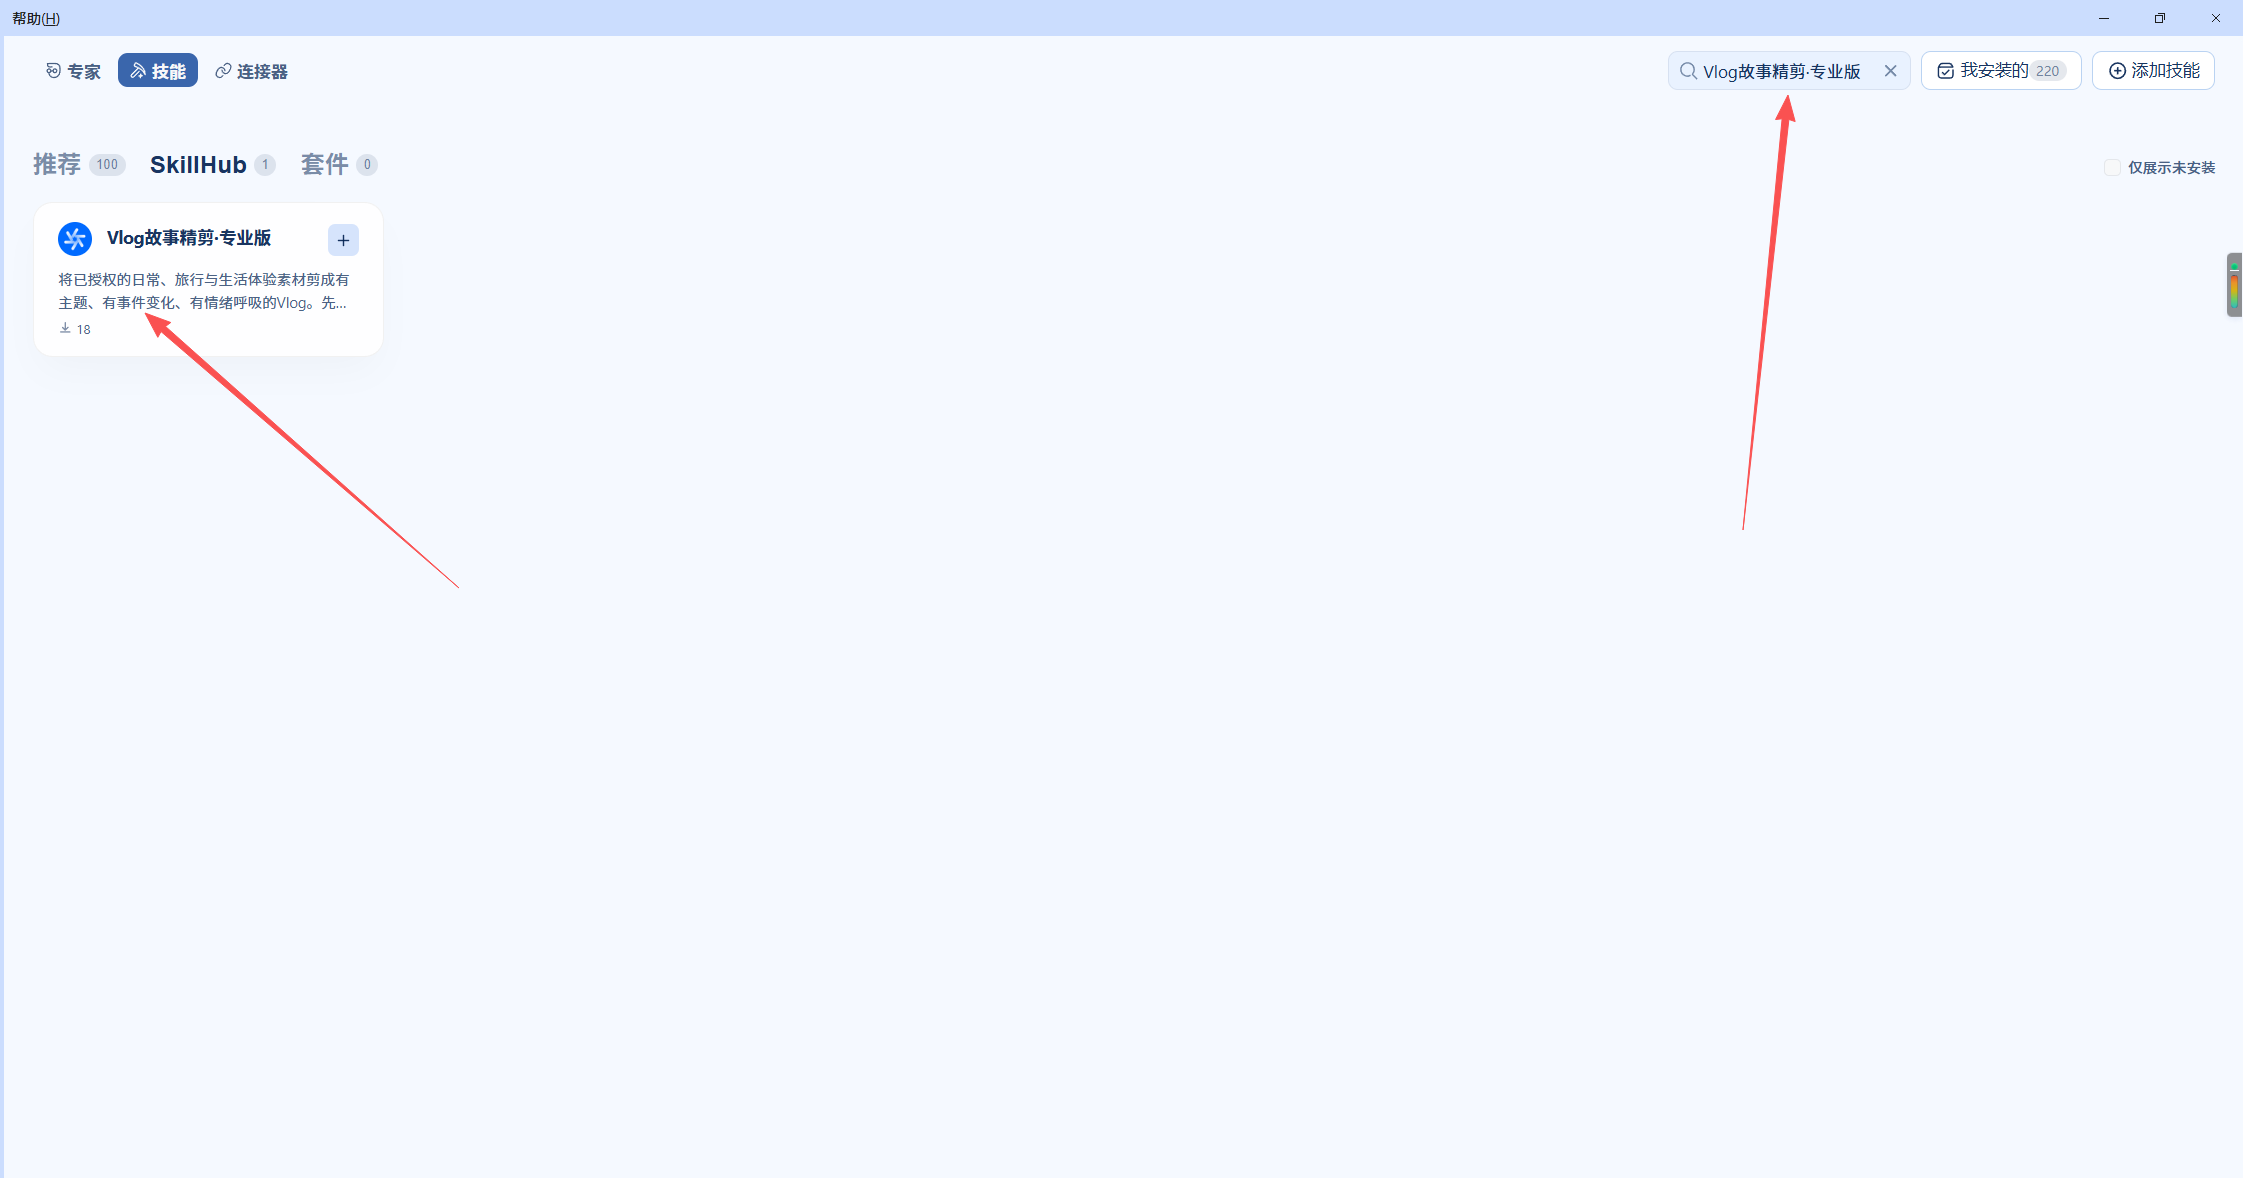
目前这套流程需要配合特定的skill会在具体的场景更好一些,系列的skill我也在开发当中,后续会同步更新到该文档,长期使用建议还是训练沉淀你自己的skill。
类型 | 适配情况 |
|---|---|
口播类 | 最擅长——本来就是按这个场景训练的 |
Vlog 类 | workbuddy技能中心搜索【Vlog故事精剪】 |
带货视频 | 开发中 |
短剧 | 开发中 |
教程与产品剪辑技能skill | workbuddy技能中心搜索【教程与产品演示剪辑技能】 |
访谈与播客精剪 | workbuddy技能中心搜索【访谈与播客精剪·专业版】 |
进阶:把流程沉淀成你自己的 Skill
这套流程真正的价值不在「剪这一条视频」,而在于把你自己反复出现的剪辑习惯固定下来——你的字幕字体与位置、你的 BGM 压多少、你的开场要不要信息卡、你的结尾怎么收。
当这些规范被沉淀成 Skill,下一期视频的剪辑就变成:换素材 → 下指令 → 验收。本次演示的实测感受是:把教程沉淀成 Skill 后,剪辑时间几乎归零,只需要花点时间下指令。
怎么开始沉淀:做完一期视频后,把「这次调过的地方」记下来(哪里的字幕重排了、BGM 压了多少、哪类动效好用),下次连同素材一起交给 AI,让它把这些偏好写进你的专属 Skill。攒够 3-5 期,你的剪辑规范就成型了。
以上就是完整流程。第一次配置大约 10 分钟,之后每期的实际投入基本就是「准备素材 + 下指令 + 验收」三步。现在就找一个文件夹,把你最近一条口播原片丢进去试试。
关于作者
我是子轩学长,一个在通往AGI之路上的探索者。创建了《AI时代的超级个体:一人OPC公司》知识库,帮助3万+人正在成为AI时代的超级个体。如果你也想在这条路上少走弯路,欢迎加入我们一起成长。
Workbuddy从入门到精通专项知识库:https://my.feishu.cn/wiki/space/7672619872920014024?ccm_open_type=lark_wiki_spaceLink&open_tab_from=wiki_home
更多内容请访问我个人的官网:https://superzixuan.com
👇 点击下方名片加入超级个体修炼群,在这里一起修炼~
微信群一群、二群已满:单独添加微信邀请进群:hanzixuan58521,备注入群。